AIを速くする方法と聞くと、まず「もっと計算能力の高いチップを作ること」を想像するかもしれません。
もちろん、計算能力は重要です。しかしAIでは、計算そのものと同じくらい、計算に必要なデータをどれだけ速く運べるかが問題になります。
Cerebras(セレブラス)は、その問題にかなり大胆な方法で取り組んでいる企業です。通常なら小さく切り分ける半導体を、ウェハ規模でつながった一つの巨大なプロセッサとして使います。
今回覚えておきたい核心は一つです。
Cerebrasの速さは、単に計算部分を大きくしたからではなく、計算・メモリ・通信を近づけ、データが動きやすい環境を作ったところから生まれている。
そもそも、なぜAIではGPUが使われるのか
コンピューターには、CPUやGPUと呼ばれるプロセッサがあります。
CPUは、さまざまな種類の処理へ柔軟に対応するのが得意です。一方のGPUは、多数の処理を並列に進め、大きな仕事量を一気にこなすよう設計されています。
AIでは、大量の計算を繰り返し行います。そのため、もともとグラフィックス処理で発展したGPUの並列計算能力が、AIとも相性がよかったのです。現在ではGPUは、AIを動かす主要な基盤の一つになっています。
ここまでは、「たくさんの計算を同時に進められるので、GPUはAIに向いている」と理解すれば十分です。
GPUを増やすだけでは解決しない問題
一つのGPUで足りなければ、複数のGPUをつなげば計算資源を増やせます。実際、大規模なAIでは多数のGPUを連携させる構成が使われています。
ただし、計算場所を増やすと、それらの間でデータを受け渡す必要も出てきます。
どれほど計算が速くても、必要なデータが届くまで待たなければ次の処理へ進めません。計算する場所とメモリの間、あるいは別々のプロセッサの間をデータが移動する時間は、AIの性能を左右する制約になります。
人間は急いでいると、つい「もっと速く走ろう」と考えます。しかし、毎回遠くの棚まで資料を取りに行く仕事なら、走り方を鍛える前に、必要な資料を机の近くへ置いた方が安定します。
Cerebrasの考え方も、まずはこの方向で捉えると分かりやすくなります。
ウェハを一つの巨大なプロセッサとして使う
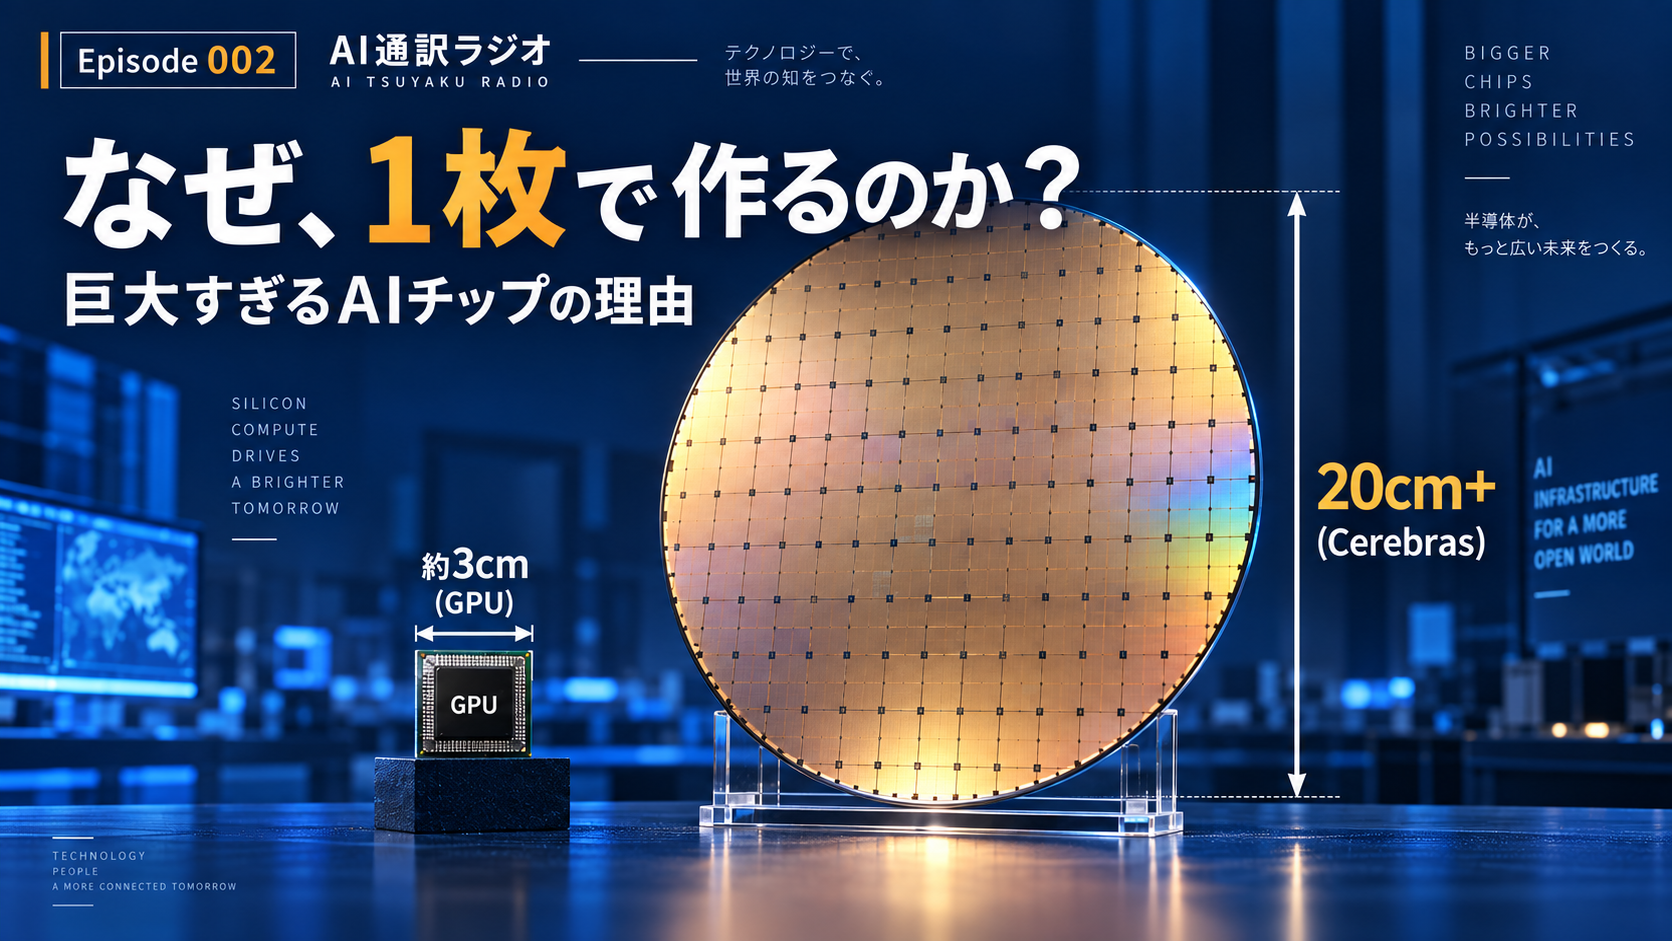
半導体は、最初に「ウェハ」と呼ばれる円盤状の基板上へ回路を作り、通常はそこから小さなダイを切り出して使います。
Cerebrasの第3世代プロセッサ「WSE-3」は、この境界を大きく変えました。ウェハ上の計算資源を相互に接続し、ウェハ規模の一つのプロセッサとして製品化しています。
WSE-3の面積は、Cerebrasの公表資料で46,225平方ミリメートル。215ミリ四方に相当します。比較のため、AIで広く使われてきたNVIDIA H100のGPUダイは814平方ミリメートルです。面積で比べると、WSE-3は約56.8倍になります。
| プロセッサ | 公表されている面積 | 見方 |
|---|---|---|
| NVIDIA H100 | 814mm² | 正方形相当で一辺約28.5mm |
| Cerebras WSE-3 | 46,225mm² | 215mm × 215mm相当 |
WSE-3には、90万個のAI向け計算コアと、44GBのオンチップSRAMが搭載されています。計算する場所、使うデータを置く場所、それらをつなぐ通信網を同じウェハ上へ高密度に配置することで、外部とのデータ移動を減らし、高い帯域幅でやり取りできるようにしています。
大切なのは「とにかく巨大にした」という見た目の話だけではありません。
必要な計算資源とデータを近づけ、遠くまで運ばなくても仕事が流れる状態を作った。
ここが、Cerebrasの設計を理解する中心です。
巨大にすると、製造時の欠陥はどうなるのか
一方で、プロセッサを巨大にすると別の問題が生まれます。
半導体の製造では、ウェハ上に微小な欠陥が発生することがあります。使う面積が大きくなるほど、どこかで欠陥に当たる可能性も高くなります。もし一か所の欠陥で全体が使えなくなるなら、ウェハ規模のプロセッサを安定して製造するのは難しくなります。
Cerebrasは、欠陥を完全になくすことだけに頼らず、一部に問題があっても全体が動けるように設計しました。
WSE-3には小さな計算コアと予備のコアがあり、通信経路にも冗長性があります。欠陥のある部分を無効にし、その場所を避けて通信を迂回させることで、論理的に機能する全体を構成します。
Cerebrasの説明では、WSE-3には物理的に97万個のコアがあり、出荷製品では90万個が有効になっています。
これは、どんな欠陥が起きても必ず問題ないという意味ではありません。重要なのは、「すべてが完璧でなければ動かない仕組み」ではなく、「一部に問題が起きることを前提に、避けながら動ける仕組み」を作ったことです。
OpenAIのUltrafastとどうつながるのか
OpenAIは2026年8月、GPT-5.6 SolをStandard処理より最大14倍高速に動かし、毎秒最大750出力トークンを生成する「Ultrafast」を先行公開しました。OpenAIは、このUltrafastがCerebrasによって動いていると説明しています。
Cerebrasによると、Ultrafast版はモデルを小さくしたものでも、蒸留したものでも、低い精度へ量子化したものでもありません。Standard endpointと同じモデルアーキテクチャ、重み、精度、コンテキスト設定、推論設定を使い、実行する側の仕組みを変えています。
大規模なモデルは一つのプロセッサだけに収まるとは限りません。Cerebrasは、モデルを複数のシステムへ層単位で分け、それぞれのウェハが担当する重みをローカルSRAMに置き、中間結果を次のウェハへ渡す方式を説明しています。
なお、「最大14倍」と「毎秒最大750出力トークン」は、どちらも最大値です。すべての用途や条件で同じ速度になるわけではありません。また、この速度は巨大なチップだけで決まるものでもありません。プロセッサ、メモリ、システム間接続、モデルの配置、推論ソフトウェアまで含む実行環境全体の結果です。
AIの競争は、モデルだけでは決まらない
ここからは、AI通訳ラジオ側の解釈です。
Cerebrasが示しているのは、既にあるコンピューターへAIをどう載せるかだけでなく、AIが自然に動きやすいコンピューター環境そのものを設計する方向です。
これは、GPUがAI向けではないという話ではありません。現在のGPUも、AI向けの計算機能、メモリ、相互接続を進化させています。また、あらゆる用途でCerebrasが常に速いと決まったわけでもありません。性能は、モデル、処理内容、システム構成、利用条件によって変わります。
それでも、Cerebrasは重要な見方を与えてくれます。
AIを速くする競争では、「どのモデルが最も賢いか」だけでなく、そのモデルが無理なく力を出せる環境をどう作るかも重要になる、という見方です。
毎回の計算をもっと頑張らせるより、計算が自然に流れる配置を先に作る。個々の部品だけではなく、全体がどんな状態なら速く、安定して動けるのかを見る。
Cerebrasの巨大なプロセッサは、その考え方を目に見える形にした、かなり分かりやすい例なのかもしれません。
まとめ
Cerebrasについて、今回覚えておきたいことは一つです。
ウェハ規模の巨大なプロセッサへ計算・メモリ・通信を集め、AIで負担になりやすいデータ移動を減らそうとしている。
速さは、計算能力の数字だけでは決まりません。必要なデータが近くにあり、一部に問題が起きても避けられ、システム全体が無理なく動き続けられることも重要です。
AIがさらに賢くなるほど、その知能をどんな環境で動かすかが、体験の違いとして見えやすくなっていきそうです。